Ao ligar um agente de IA ao fluxo de alertas de segurança do time, a primeira pergunta costuma ser se ele funciona. Mas a pergunta mais importante vem depois: até onde ele pode ir sozinho? Minha posição é que automatizar a defesa não tira o humano da decisão. O agente investiga, correlaciona e propõe. Quem aprova uma ação que altera o ambiente, como isolar um servidor ou revogar um acesso, continua sendo o engenheiro.
Não existe mágica aqui. O ponto certo dessa aprovação depende do custo de errar em cada tarefa. Quem não desenhou isso na arquitetura vai descobrir o limite só depois do incidente.
O agente investiga, o engenheiro aprova
Pense num time que liga um agente ao fluxo de alertas. Antes de qualquer coisa, ele precisa separar dois tipos de tarefa.
A primeira lê e correlaciona: investigar, enriquecer o alerta, montar o caso, propor uma resposta. A segunda escreve no ambiente: isolar um servidor, revogar um acesso.
O agente faz a primeira parte sem atrito. A segunda passa pelo engenheiro.
Esse desenho não é só preferência minha. Ele coincide com um nível do modelo escalonado de autonomia da Gartner, o "Act with Approval", em que o agente só executa ações que escrevem dados ou alteram o ambiente depois de aprovação humana explícita, toda vez 1.
Quanto custa errar e em que escala
O critério para colocar o humano no loop é o custo do erro, não uma desconfiança genérica na IA. Um erro que se desfaz com um clique é um problema. Um que se multiplica é outro.
A Kaspersky, que é fabricante e, portanto, opina com interesse, argumenta que num SOC (Security Operations Center, o centro de operações de segurança) totalmente autônomo uma única alucinação pode disparar ações danosas em centenas ou milhares de endpoints ao mesmo tempo 2. Trato isso como argumento, não como medição. Ainda assim, ele aponta para a escala do estrago.
Não é o agente que me preocupa. É o tamanho do estrago quando ele erra.
A reversibilidade também entra na conta. Um guia do Non-Human & AI Identity Management Group (NHIMG), entidade de mercado e não órgão de padrões, diz que mudanças irreversíveis pedem aprovação humana explícita 3. Os exemplos são desativar identidades de produção ou desligar cargas críticas. O mesmo material afirma que revogar acesso, encerrar sessões ou suprimir telemetria costumam exigir aprovação, salvo override de emergência documentado 3.
O limite é por ativo, não global
Não há um único ponto certo para o humano. Ele muda conforme a tarefa e conforme o ativo. A Expel, por exemplo, deixa o cliente permitir ou negar a automação de isolamento host a host 4. O limite é calibrado por ativo, não definido uma vez para tudo.
Vou montar um cenário hipotético, sem cliente nem número real. Às três da manhã, o agente recebe o alerta de uma conta de serviço usada fora do horário de costume. Ele correlaciona os logins e consulta o inventário. Descobre que a mesma credencial tocou duas máquinas: uma VM de laboratório e o servidor que roda a rotina noturna de produção. Então propõe duas ações.
A primeira é isolar a VM de laboratório. Se o isolamento estiver errado, alguém religa a máquina de manhã e o custo é um café frio. Aqui o time pode liberar a execução automática.
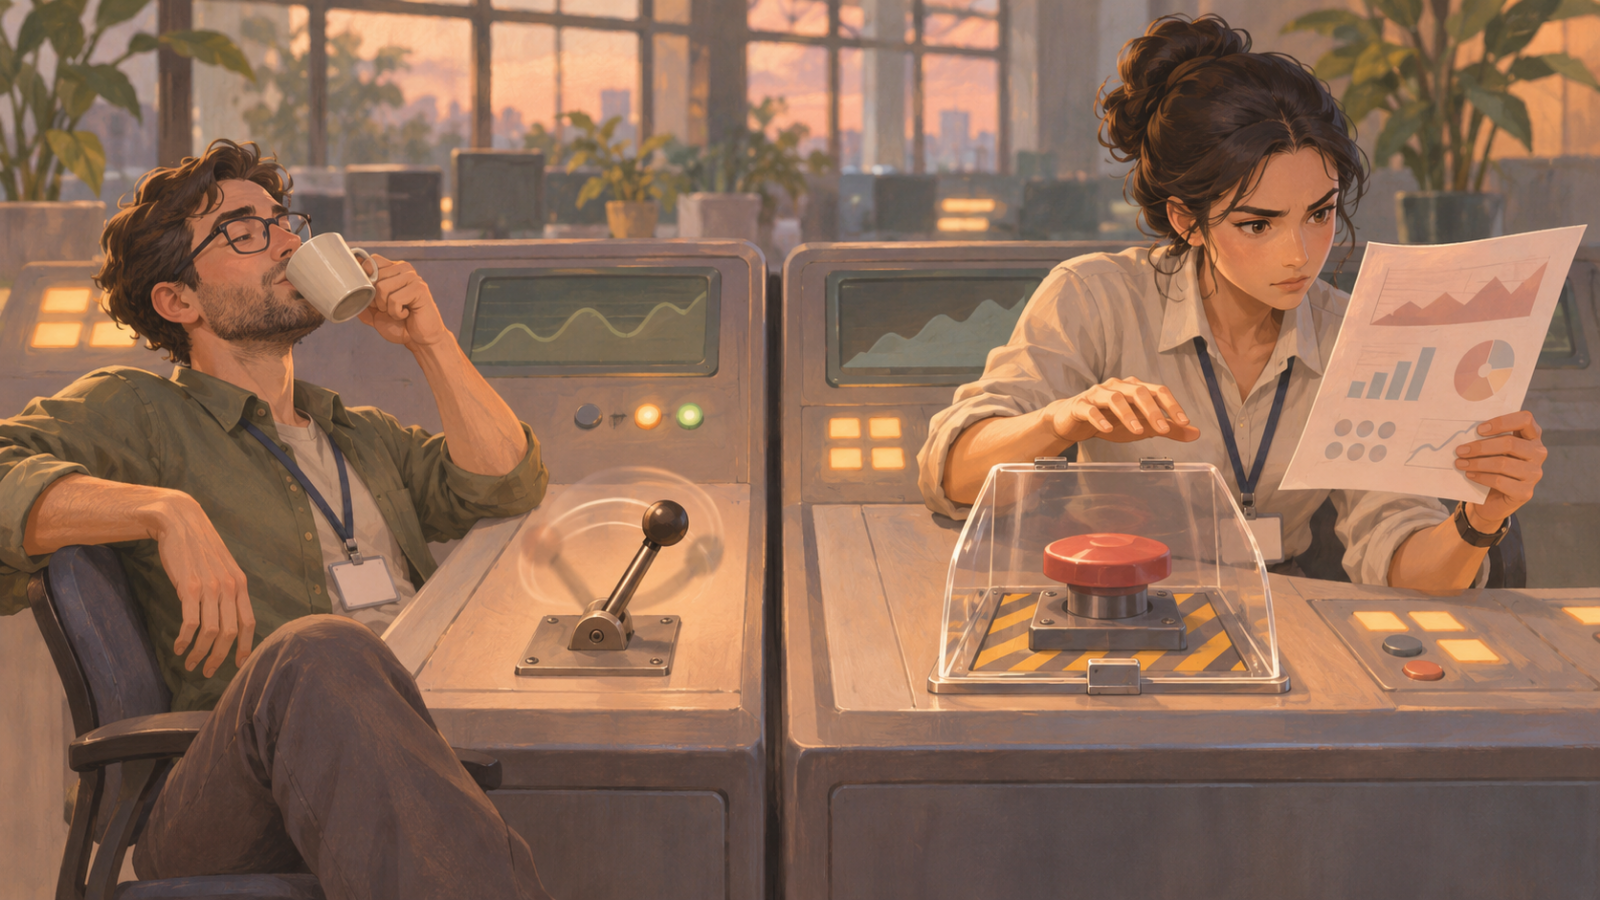
A segunda é revogar a conta de serviço. Se o alerta for falso positivo, a rotina de produção para no meio da madrugada. Depois disso, restabelecer o acesso significa trocar a credencial em tudo que depende dela. Essa ação espera o engenheiro, e ele só aprova com a evidência na tela: os logins que o agente correlacionou, o que ele já fez e o que vai mudar.
O agente é o mesmo, a investigação é a mesma, e o limite é diferente porque o custo de errar é diferente.
A promessa de automatizar tudo também merece desconfiança. Segundo a Kaspersky, poucas organizações obtiveram retorno relevante com decisão e resposta autônomas 2. Ela cita ainda a previsão da Gartner de que nunca haverá um SOC autônomo, que segue válida em 2026 2. É opinião de fabricante, e a trato como tal, mas vai na mesma direção do custo de errar.
Aprovar não basta: o humano também pode ser manipulado
Há um contraponto honesto à minha tese. O OWASP Top 10 for Agentic Applications inclui a exploração da confiança humana no agente (ASI09). Como resume a HUMAN Security, usuários confiam demais nas recomendações do agente, e um atacante pode usar isso para influenciar decisões ou extrair credenciais 5.
Ou seja, o humano que aprova também pode ser manipulado. Isso tem uma consequência de desenho: o clique de aprovação só vale se o engenheiro vê a evidência, o que o agente fez e o que vai mudar. Aprovar sem contexto é só uma assinatura.
O humano no loop é decisão de arquitetura, não detalhe de interface.
Isso reforça a tese em vez de derrubá-la. Se a aprovação importa, ela precisa ser projetada para funcionar.
Quem não desenhou isso descobre o limite depois do incidente
Se o ponto do humano não foi definido na arquitetura, o limite aparece na pior hora: depois da ação errada em produção.
Segurança se pensa desde a arquitetura, não só na resposta a incidentes. Com agentes, isso inclui decidir de antemão o que eles podem tocar e o que só tocam com aprovação.
Minha posição: não existe um limite de autonomia que sirva para todo agente e todo ativo. O agente investiga, correlaciona e propõe. A ação que altera o ambiente continua com o engenheiro, e o quanto de liberdade sobra ao agente depende do custo de errar em cada tarefa.
Na prática, liste as ações que o seu agente pode executar e classifique cada uma por reversibilidade e alcance. Defina antes do incidente quais exigem aprovação e como o aprovador vê a evidência: o que o agente fez e o que vai mudar. Troque ideias com outros engenheiros e embase suas escolhas nos prós e contras.